13 min de lecturemis à jour le
Chiffrement côté client avec AES-256-GCM et PBKDF2 : le cas DashFlow
Comment DashFlow chiffre budget et dossiers médicaux dans le navigateur avec la Web Crypto API : PBKDF2, AES-256-GCM, double enveloppe de clés, clé non extractible en IndexedDB. Architecture zero-knowledge Angular/NestJS, code à l'appui, et les pièges rencontrés.
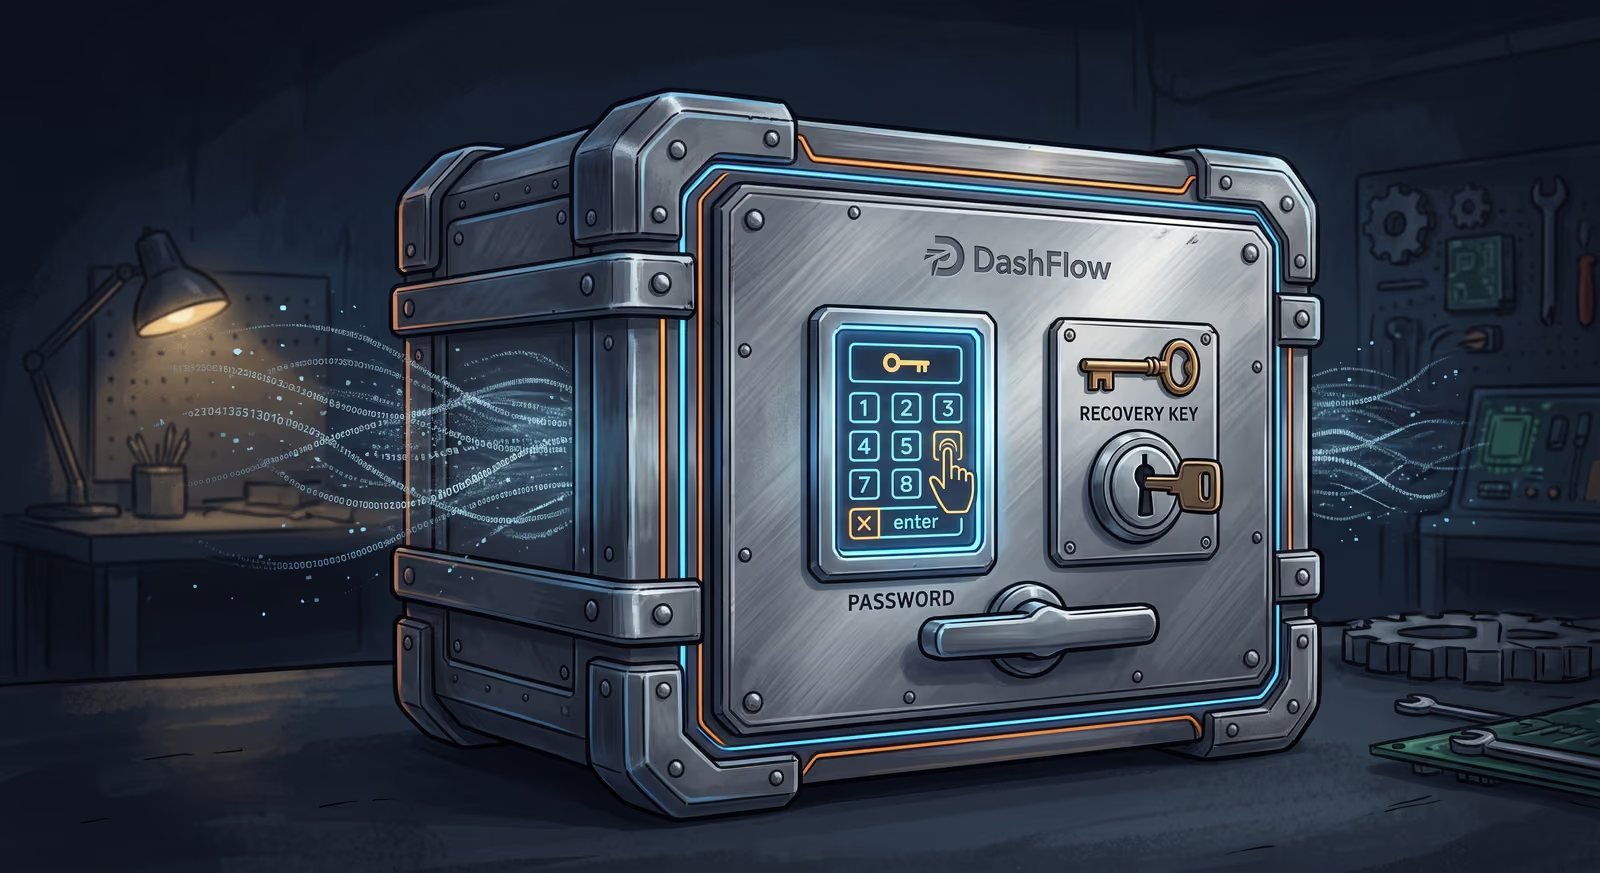
DashFlow gère le budget et le suivi médical de la famille : comptes bancaires, enveloppes, prêts, fiches de paie, ordonnances, rendez-vous, documents scannés. Autrement dit, exactement le genre de données que je n'ai aucune envie de voir traîner en clair dans une base PostgreSQL, même la mienne, même sur mon propre VPS.
Dans le premier article, j'avais promis de revenir en détail sur le chiffrement côté client de DashFlow. C'est le sujet de celui-ci : comment j'ai mis en place un chiffrement de bout en bout (E2EE) avec la Web Crypto API du navigateur, AES-256-GCM pour les données, PBKDF2 pour dériver une clé depuis le mot de passe, et une double enveloppe de clés pour que le serveur ne puisse jamais rien lire. Avec du code, parce que c'est là que ça se joue, et avec les pièges dans lesquels je suis tombé, parce que bien chiffrer est plus piégeux qu'il n'y paraît.
Pourquoi chiffrer côté client, et pas seulement "au repos"
Quand on parle de sécurité d'une application web, on pense d'abord à HTTPS et au chiffrement du disque. Les deux sont nécessaires, mais ils protègent le transport et le support physique. Ils ne protègent pas contre le cas le plus banal : le serveur lui-même. Une injection SQL, un dump de base qui fuite, un accès admin compromis, une sauvegarde mal rangée, et tout est lisible.
Le modèle de menace que je me suis fixé pour DashFlow est simple à énoncer : si quelqu'un compromet mon serveur, il repart avec des octets illisibles. Le serveur est "zero-knowledge", il stocke des données chiffrées qu'il ne peut pas ouvrir, parce que la clé qui permet de les ouvrir n'a jamais quitté le navigateur.
Ça a un revers, et je préfère l'écrire noir sur blanc plutôt que de le cacher dans une FAQ : si vous perdez votre mot de passe et votre clé de récupération, personne ne peut déchiffrer vos données, moi compris. C'est le prix honnête du zero-knowledge.
L'architecture : une double enveloppe de clés
Le premier réflexe, quand on découvre le chiffrement côté client, c'est de dériver une clé depuis le mot de passe et de chiffrer directement les données avec. Ça marche, jusqu'au jour où l'utilisateur change de mot de passe : il faut alors rechiffrer toute sa base. Sur un téléphone, avec des centaines de transactions et des pièces jointes, ce n'est pas envisageable.
DashFlow utilise donc deux niveaux de clés, ce qu'on appelle une double enveloppe (ou "envelope encryption").
La clé maîtresse est une clé AES-256 tirée au hasard à la création du compte. C'est elle, et elle seule, qui chiffre les données métier. Elle ne dépend pas du mot de passe.
La clé d'enveloppe est dérivée du mot de passe avec PBKDF2. Elle ne sert qu'à une chose : emballer (wrap) la clé maîtresse pour pouvoir la stocker sur le serveur sous forme chiffrée.
Voici la dérivation, telle qu'elle est dans le code :
const PBKDF2_ITERATIONS = 600_000;
const KEY_BITS = 256;

async deriveWrappingKey(password: string, salt: Uint8Array): Promise<CryptoKey> {
  const keyMaterial = await crypto.subtle.importKey(
    'raw',
    new TextEncoder().encode(password),
    'PBKDF2',
    false,
    ['deriveBits', 'deriveKey'],
  );

  return crypto.subtle.deriveKey(
    { name: 'PBKDF2', salt, iterations: PBKDF2_ITERATIONS, hash: 'SHA-256' },
    keyMaterial,
    { name: 'AES-KW', length: KEY_BITS },
    false,
    ['wrapKey', 'unwrapKey'],
  );
}
Trois détails comptent ici. Le sel de 16 octets est aléatoire et propre à chaque compte, ce qui rend inutiles les tables précalculées. Les 600 000 itérations de PBKDF2-SHA-256 sont dans la fourchette recommandée par l'OWASP : un peu moins d'une seconde sur un ordinateur portable, ce qui reste acceptable à la connexion et devient très coûteux pour qui voudrait tester des millions de mots de passe. Et la clé dérivée est de type AES-KW, l'algorithme de "key wrapping" de la Web Crypto API, conçu précisément pour chiffrer une autre clé.
La création du compte assemble tout ça :
async setupEncryption(password: string): Promise<string> {
  const masterKey = await this.crypto.generateMasterKey();        // AES-256, aléatoire
  const salt = this.crypto.generateSalt();                         // 16 octets aléatoires
  const recoveryKey = this.crypto.generateRecoveryKey();           // 32 octets, affichés en hexa

  const wrappingKey = await this.crypto.deriveWrappingKey(password, salt);
  const recoveryWrappingKey = await this.crypto.deriveWrappingKeyFromRecovery(recoveryKey);

  const wrappedMasterKey = await this.crypto.wrapKey(masterKey, wrappingKey);
  const recoveryWrappedKey = await this.crypto.wrapKey(masterKey, recoveryWrappingKey);

  this.auth.updateKeyMaterial({ salt: bytesToHex(salt), wrappedMasterKey, recoveryWrappedKey });
  return recoveryKey; // montrée une seule fois à l'utilisateur
}
Le serveur reçoit et stocke trois valeurs : le sel, la clé maîtresse emballée par le mot de passe, et la même clé maîtresse emballée par la clé de récupération. Côté NestJS, ça tient en trois colonnes texte sur la table utilisateur. Aucune de ces valeurs ne permet de retrouver la clé maîtresse sans le mot de passe ou la clé de récupération.
Ce qu'on gagne avec cette double enveloppe :
Changer de mot de passe revient à dériver une nouvelle clé d'enveloppe et à ré-emballer la clé maîtresse. Une opération, quelques millisecondes, zéro donnée rechiffrée.
La clé de récupération est une seconde porte d'entrée vers la même clé maîtresse. Si le mot de passe est oublié, elle permet de déverrouiller, puis de ré-emballer la clé maîtresse avec un nouveau mot de passe.
Et surtout, chaque appareil peut retrouver la clé maîtresse à partir du mot de passe, sans qu'aucune clé ne transite jamais en clair.
AES-256-GCM : un IV unique pour chaque donnée chiffrée
Une fois la clé maîtresse déverrouillée, chaque donnée sensible est chiffrée en AES-256-GCM avant de partir vers l'API.
const IV_BYTES = 12;

export async function encryptWithKey(plaintext: string, key: CryptoKey): Promise<string> {
  const iv = crypto.getRandomValues(new Uint8Array(IV_BYTES));
  const encoded = new TextEncoder().encode(plaintext);
  const ciphertext = await crypto.subtle.encrypt({ name: 'AES-GCM', iv }, key, encoded);

  // Le blob final = IV (12 octets) + chiffré + tag d'authentification GCM
  const combined = new Uint8Array(IV_BYTES + ciphertext.byteLength);
  combined.set(iv);
  combined.set(new Uint8Array(ciphertext), IV_BYTES);

  return bufferToBase64(combined.buffer);
}

export async function decryptWithKey(blob: string, key: CryptoKey): Promise<string> {
  const combined = new Uint8Array(base64ToBuffer(blob));
  const iv = combined.slice(0, IV_BYTES);
  const ciphertext = combined.slice(IV_BYTES);
  const plainBuffer = await crypto.subtle.decrypt({ name: 'AES-GCM', iv }, key, ciphertext);
  return new TextDecoder().decode(plainBuffer);
}
Pourquoi GCM plutôt qu'un simple AES-CBC ? Parce que GCM est un mode de chiffrement authentifié : il produit un tag d'intégrité en plus du chiffré. Si un seul octet est modifié en base, le déchiffrement échoue proprement au lieu de renvoyer des données corrompues sans prévenir. Pour une application de budget, savoir qu'un montant n'a pas été altéré vaut autant que savoir qu'il n'a pas été lu.
La règle absolue de GCM, c'est de ne jamais réutiliser un vecteur d'initialisation (IV) avec la même clé. Ici l'IV de 12 octets est tiré au hasard à chaque appel et préfixé au blob, ce qui rend le déchiffrement autonome : pas besoin de stocker l'IV ailleurs. J'ai un test dédié qui vérifie que deux chiffrements du même texte produisent deux résultats différents. Ce n'est pas un test sophistiqué, mais c'est celui qui m'aurait sauvé si un jour quelqu'un avait remplacé le tirage aléatoire par une constante "pour débugger".
Séparer ce qui reste en clair de ce qui est chiffré
Chiffrer une chaîne, c'est facile. La vraie question d'architecture, c'est : quels champs chiffre-t-on, et à quoi ressemble la ligne en base ?
J'ai choisi une approche uniforme pour toutes les entités : chaque table garde ses colonnes techniques en clair (identifiant, propriétaire, dates de création) et tout le reste part dans une seule colonne encryptedData. Le découpage se fait dans le navigateur, avec une liste blanche explicite par entité.
export async function encryptEntity<T extends Record<string, unknown>>(
  data: T,
  cleartextKeys: readonly (keyof T)[],
  key: CryptoKey,
): Promise<Record<string, unknown> & { encryptedData: string }> {
  const cleartext: Record<string, unknown> = {};
  const sensitive: Record<string, unknown> = {};

  for (const [k, v] of Object.entries(data)) {
    if (cleartextKeys.includes(k as keyof T)) cleartext[k] = v;
    else sensitive[k] = v;
  }

  const encryptedData = await encryptWithKey(JSON.stringify(sensitive), key);
  return { ...cleartext, encryptedData };
}
Et dans une gateway Angular, par exemple celle des comptes bancaires :
const CLEARTEXT_KEYS = ['id', 'userId', 'createdAt'] as const;

create(data: Omit<BankAccount, 'id'>): Observable<BankAccount> {
  return mutateEncrypted(
    data as Record<string, unknown>,
    CLEARTEXT_KEYS,
    this.crypto.getMasterKey(),
    (body) => this.api.post<ApiRow>('/bank-accounts', body),
  );
}
La liste blanche est volontairement inversée par rapport à l'intuition. Tout ce qui n'est pas explicitement déclaré "en clair" est chiffré. Ajouter un champ à une entité le chiffre par défaut ; il faut une décision consciente pour l'exposer au serveur. C'est le même principe que le typage strict : le comportement sûr est celui qu'on obtient sans rien faire.
Côté NestJS, les colonnes historiques (nom, montant, type) reçoivent des valeurs de remplissage neutres, "[chiffré]" ou "0", uniquement pour satisfaire les contraintes du schéma. Le serveur valide la forme du payload, vérifie que l'utilisateur est bien propriétaire de la ligne, et stocke. Il ne sait pas ce qu'il stocke.
Cette décision a une conséquence qu'il faut assumer : le serveur ne peut plus rien calculer. Pas de somme des transactions en SQL, pas de projection de budget côté API, pas de recherche sur le nom d'un praticien. Tous les calculs de DashFlow (soldes d'enveloppes, échéances de prêts, statistiques sur douze mois) sont faits dans le navigateur, sur des données déchiffrées. J'ai dû déplacer plusieurs calculs qui vivaient côté API. C'est un vrai coût, et c'est le bon compromis pour ce type de données.
Le piège que j'ai corrigé : une clé maîtresse lisible par n'importe quel script
C'est la partie de l'article que je tenais le plus à écrire, parce que c'est là que "bien chiffrer" se distingue de "chiffrer".
Dans une première version, après le déverrouillage, j'exportais la clé maîtresse en base64 dans sessionStorage pour survivre à un rechargement de page. Fonctionnellement, parfait. En termes de sécurité, c'était une erreur sérieuse : n'importe quel script exécuté dans la page, via une faille XSS ou une dépendance compromise, pouvait lire cette clé et déchiffrer l'intégralité des données. Le chiffrement de bout en bout ne protégeait plus que du serveur, pas du navigateur. Un audit de sécurité que j'ai mené sur le code l'a classé critique, et il avait raison.
La correction repose sur une propriété de la Web Crypto API que je ne connaissais pas assez : une CryptoKey peut être créée non extractible. Elle reste utilisable pour chiffrer et déchiffrer, mais aucun code JavaScript ne peut jamais lire ses octets. Et comme IndexedDB supporte le clonage structuré des objets CryptoKey, on peut persister la clé elle-même, pas sa valeur.
async unwrapKey(wrappedBase64: string, wrappingKey: CryptoKey, extractable = false): Promise<CryptoKey> {
  return crypto.subtle.unwrapKey(
    'raw',
    base64ToBuffer(wrappedBase64),
    wrappingKey,
    'AES-KW',
    { name: 'AES-GCM', length: KEY_BITS },
    extractable,               // false : la clé n'est jamais lisible en JS
    ['encrypt', 'decrypt'],
  );
}

/** Restaure la clé maîtresse (non extractible) persistée en IndexedDB après un rechargement. */
async restoreFromStorage(): Promise<boolean> {
  const key = await idbGet(MASTER_KEY_ID);
  if (!key) return false;
  this._masterKey.set(key);
  return true;
}
Il reste un cas où une copie extractible est nécessaire : le ré-emballage de la clé maîtresse lors d'un changement de mot de passe ou d'une rotation de la clé de récupération. Cette copie existe uniquement en mémoire, depuis le dernier déverrouillage de la session, et n'est jamais persistée. Après un simple rechargement de page, elle vaut null : l'application redemande le mot de passe avant tout ré-emballage. Ce n'est pas très confortable pour l'utilisateur une fois par an, et c'est exactement le bon endroit pour lui demander un petit effort.
La leçon que j'en tire : le chiffrement n'est pas un algorithme, c'est un cycle de vie. Où la clé naît, où elle vit, qui peut la lire, quand elle meurt. Le mode lock() vide la mémoire et supprime l'entrée IndexedDB. Le protocole et le format des données chiffrées n'ont pas changé d'un octet entre les deux versions ; seule la garde de la clé a changé, et c'est ce qui a fait toute la différence.
Les fichiers aussi : ordonnances et fiches de paie
Une application de santé sans pièces jointes ne sert pas à grand-chose. Les ordonnances, les résultats d'analyses, les fiches de paie sont chiffrés avec la même clé maîtresse, en binaire cette fois.
export async function encryptFile(file: File, key: CryptoKey): Promise<Blob> {
  const data = await file.arrayBuffer();
  const encrypted = await encryptBufferWithKey(data, key);   // même schéma : IV + AES-GCM
  return new Blob([encrypted], { type: 'application/octet-stream' });
}

export async function decryptFile(encryptedBlob: Blob, key: CryptoKey, mimeType: string): Promise<Blob> {
  const data = await encryptedBlob.arrayBuffer();
  const decrypted = await decryptBufferWithKey(data, key);
  return new Blob([decrypted], { type: mimeType });
}
Le stockage objet (compatible S3) ne voit passer que des flux application/octet-stream sans aucune information exploitable, pas même le type du fichier. Le type MIME réel voyage dans les métadonnées chiffrées de l'entité et n'est restauré que dans le navigateur, au moment de l'affichage.
Valider ce qu'on déchiffre
Un point que je n'avais pas anticipé : une fois les données déchiffrées, elles reviennent d'un JSON opaque que le serveur n'a jamais pu valider. Un bug d'une ancienne version du front, une migration incomplète, et on se retrouve avec une ligne dont le montant est une chaîne au lieu d'un nombre. Le serveur ne peut pas vous protéger de ça, puisqu'il ne voit rien.
Chaque entité déchiffrée passe donc par un schéma Zod avant d'atteindre le domaine. Une ligne invalide est exclue et signalée, sans jamais logger la valeur déchiffrée elle-même :
function reportInvalid(ctx: ValidateCtx, issues: readonly z.core.$ZodIssue[]): void {
  // Ne jamais logger `issues` brut : il pourrait contenir la valeur déchiffrée fautive.
  const safeIssues = issues.map((i) => ({ code: i.code, path: i.path }));
  console.error(`[E2EE] ${ctx.entity} : ligne déchiffrée invalide, exclue.`, safeIssues);
}
C'est un détail, mais c'est le genre de détail qui fait qu'un chiffrement de bout en bout tient réellement ses promesses : à quoi bon chiffrer des données médicales si elles finissent en clair dans la console du navigateur au premier bug ?
Ce que ça change dans le code NestJS
Paradoxalement, le backend est devenu plus simple. Les contrôleurs acceptent deux formes de payload, en clair pour le compte de démonstration et chiffré pour les vrais comptes, et se contentent de valider la forme, de vérifier la propriété de la ligne et de persister. Un endpoint de migration permet à un compte existant de passer au chiffrement : le navigateur déchiffre, rechiffre et renvoie chaque ligne, le serveur remplace les colonnes en clair par leurs valeurs neutres. Un endpoint de suppression efface définitivement les données chiffrées et le matériel de clés.
Le serveur garde ses responsabilités classiques, authentification par session, protection CSRF, double authentification TOTP, limitation de débit. Il a simplement perdu la capacité de lire ce qu'il garde, et c'était le but.
Les limites, honnêtement
Un chiffrement côté client ne protège pas d'un navigateur compromis. Une faille XSS dans l'application reste la menace principale, et c'est pour ça que le passage à une clé non extractible comptait autant : elle transforme "lire la clé une fois" en "devoir rester dans la page pour déchiffrer", ce qui est beaucoup plus détectable. La Content Security Policy et l'absence de dépendances inutiles font le reste.
PBKDF2 n'est pas le meilleur algorithme de dérivation disponible. Argon2id résiste mieux aux attaques par GPU. Mais il n'est pas implémenté nativement dans la Web Crypto API, et embarquer une implémentation WebAssembly non auditée m'a paru plus risqué que d'utiliser PBKDF2 avec un nombre d'itérations élevé. C'est un choix que je réévaluerai quand le support natif arrivera.
Enfin, le zero-knowledge interdit toute fonctionnalité côté serveur qui aurait besoin de lire les données : recherche plein texte, notifications basées sur un contenu, agrégations. Pour une application familiale, c'est acceptable. Pour un produit d'équipe, ce serait une discussion sérieuse à avoir avant d'écrire la première ligne.
Ce que je retiens
Le plus difficile n'a pas été de choisir les algorithmes ; AES-256-GCM et PBKDF2 sont des choix documentés, disponibles nativement dans tous les navigateurs modernes. Le plus difficile a été de raisonner sur le cycle de vie des clés, de décider ce qui reste en clair et pourquoi, de déplacer des calculs métier hors du serveur, et d'accepter qu'un audit honnête de mon propre code révèle une faille critique que je devais corriger.
C'est la même exigence que dans mon ancien métier : comprendre toute la chaîne avant d'y toucher, et ne pas se contenter de "ça marche". Un chiffrement qui fonctionne mais dont la clé est lisible par n'importe quel script, ça marche. Ça ne protège personne.
DashFlow est en ligne sur dashflow.nedellec-julien.fr, avec une démo accessible sans inscription, et le code est public sur GitHub. L'ensemble tourne sur mon propre VPS, déployé et maintenu par mes soins.
Ce que je cherche maintenant
Je suis en recherche d'un poste de développeur Full-Stack, Angular, NestJS, TypeScript, de préférence dans un environnement où la sécurité des données et l'impact du produit comptent vraiment : santé, GreenTech, industrie, secteurs où une donnée mal protégée a des conséquences concrètes.
Si ce profil vous parle, chiffrement pensé de bout en bout, rigueur d'atelier appliquée au code, autonomie sur toute la chaîne, mes coordonnées sont sur nedellec-julien.fr.